一、大数据概念
大数据(Big Data)是指无法在可容忍的时间内用传统IT技术和软硬件工具对其进行感知、获取、管理、处理和服务的数据集合。通常用5V特征来概括:Volume(体量大)、Velocity(速度快)、Variety(多样性)、Value(价值密度低)、Veracity(真实性)。大数据技术栈涵盖了分布式存储(如HDFS、S3)、分布式计算(如MapReduce、Spark、Flink)、数据仓库(如Hive、ClickHouse)、NoSQL数据库(如HBase、Cassandra)以及资源调度(如YARN、Kubernetes)等。其核心目标是从海量、多源、异构的数据中提取有价值的信息,支撑决策与创新。
二、大数据Shuffle调优
Shuffle是分布式计算框架中连接Map阶段和Reduce阶段的关键过程,涉及数据的分区、排序、溢写、拉取和合并。Shuffle性能直接影响作业的执行效率,尤其在大规模数据下易成为瓶颈。调优策略包括:
- 减少Shuffle数据量:通过Map端聚合(Combiner)、过滤无用小数据、使用广播变量避免Reduce端Join等方式,从源头降低传输的数据量。
- 调整缓冲区与溢出参数:在Hadoop MapReduce中,
mapreduce.task.io.sort.mb控制Map输出缓冲区大小,mapreduce.map.sort.spill.percent控制溢写阈值;在Spark中,spark.shuffle.file.buffer(默认32KB)可适当调大至64KB或128KB,减少磁盘I/O次数。 - 优化分区策略:避免数据倾斜,可使用自定义分区器或
spark.default.parallelism、spark.sql.shuffle.partitions调整并行度。对于倾斜Key,可采用加盐、拆分或Map Join等方式。 - 压缩与序列化:使用高效的压缩算法(如Snappy、LZ4)和序列化库(如Kryo)减少网络传输和磁盘占用。Spark中设置
spark.serializer=org.apache.spark.serializer.KryoSerializer并注册自定义类。 - 拉取与合并调优:调整
spark.reducer.maxSizeInFlight(Reduce端一次拉取的数据量,默认48MB)和spark.shuffle.io.maxRetries(重试次数)以增强稳定性。 - 硬件与网络:使用SSD替代HDD、增加网络带宽、采用RDMA等技术可显著提升Shuffle性能。
三、参数调优
参数调优是提升大数据作业性能的重要手段,需结合具体框架、数据特征和集群资源进行。以下以Spark和Hadoop为例:
3.1 Spark调优参数
- 资源参数:
spark.executor.memory(Executor内存)、spark.executor.cores(核数)、spark.executor.instances(Executor数量)需根据集群规模和作业需求权衡。 - 并行度:
spark.default.parallelism控制RDD的默认分区数,建议设为Executor核数的2~3倍;spark.sql.shuffle.partitions针对Spark SQL的Shuffle分区,默认200,可根据数据量调整为更大值。 - 内存管理:
spark.memory.fraction(执行与存储内存占比,默认0.6)、spark.memory.storageFraction(存储内存占比,默认0.5)可调整以避免频繁GC或OOM。 - GC调优:使用G1垃圾回收器(
-XX:+UseG1GC),调整spark.executor.extraJavaOptions中的-XX:InitiatingHeapOccupancyPercent等参数。
3.2 Hadoop调优参数
- MapReduce:
mapreduce.map.memory.mb、mapreduce.reduce.memory.mb设置容器内存;mapreduce.reduce.shuffle.parallelcopies增加Reduce端并行拉取数(默认5)。 - YARN:
yarn.nodemanager.resource.memory-mb、yarn.scheduler.maximum-allocation-mb控制节点可用资源和单容器最大内存。
3.3 调优方法论
参数调优不是孤立的,需通过监控(如Spark UI、YARN ResourceManager)识别瓶颈,采用A/B测试逐步调整,避免过度调参导致稳定性下降。建议建立基准测试,记录不同参数组合下的性能指标。
四、数据处理
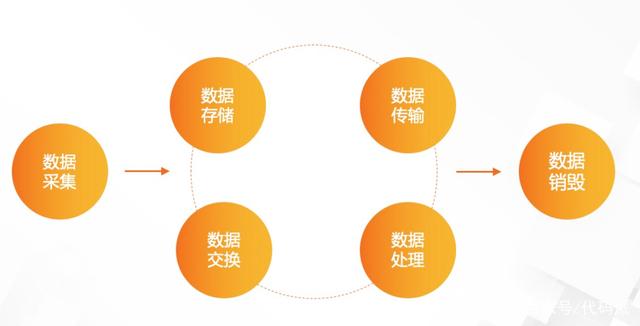
大数据处理涵盖数据采集、存储、计算、分析和可视化等环节。常见处理模式包括:
- 批处理:适用于历史数据分析,如MapReduce、Spark Core。需关注数据分区、Join策略、缓存与持久化(如
persist(StorageLevel.MEMORY<em>AND</em>DISK))。 - 流处理:适用于实时场景,如Spark Streaming、Flink。需处理事件时间、水位线、状态管理和Exactly-Once语义。典型调优包括调整批处理间隔、并行度、反压机制等。
- 交互式分析:如Spark SQL、Presto、Impala。优化手段包括分区裁剪、谓词下推、列式存储(Parquet/ORC)、向量化执行。
- 数据倾斜处理:在Join、GroupBy等操作中,倾斜会导致长尾任务。解决方案有:拆分大Key、加随机前缀、使用Map-Side Join、动态分区等。
- 数据质量与清洗:处理缺失值、异常值、重复数据,确保数据一致性。可借助DataFrame API或SQL进行转换。
- 数据湖与湖仓一体:Delta Lake、Iceberg、Hudi等技术支持ACID、Schema演进,结合 spark 可构建高效管道。
五、
大数据技术栈的深度和广度要求开发者不仅要理解概念,还需掌握Shuffle调优、参数调优和多样化数据处理方法。通过系统性调优和合理的数据处理策略,可以显著提升作业性能、降低资源消耗,从而更好地释放数据价值。随着云原生和AI融合,大数据处理将更加智能化、自动化,值得持续关注。