在当今数据驱动的时代,产品数据运营体系已成为企业实现精细化运营、提升用户体验和推动业务增长的核心引擎。许多团队在构建数据运营体系时,往往陷入“有数据、无运营”的困境:数据分散、指标混乱、分析滞后、行动脱节。本文将通过一个实战案例,拆解构建产品数据运营体系的11个关键步骤,并聚焦数据处理的底层逻辑,帮助你搭建一套可落地、可迭代的数据运营框架。
一、为什么需要产品数据运营体系?
产品数据运营体系,是指围绕产品目标,通过系统化的数据采集、处理、分析和应用,驱动产品决策与运营行动的一整套机制。它不仅仅是搭建报表或看板,而是将数据嵌入到产品迭代、用户增长、商业变现的全流程中。
一个成熟的数据运营体系,通常具备以下特征:
- 数据采集全面、准确、及时;
- 数据处理规范、可追溯、可复用;
- 指标体系分层清晰,能反映业务健康度;
- 分析洞察能快速转化为运营策略;
- 形成“数据-洞察-行动-反馈”的闭环。
二、实战案例背景
某在线教育产品,月活用户约500万,主要功能包括课程浏览、试听、购买、学习打卡等。随着业务扩张,团队发现:
- 数据口径不统一,运营、产品、技术各执一词;
- 关键转化率下降,但无法定位原因;
- 用户行为数据埋点混乱,大量无效数据;
- 报表输出靠手动跑SQL,效率低下。
为此,团队决定从0到1构建产品数据运营体系,并按照以下11个步骤推进。
三、构建产品数据运营体系的11个步骤
步骤1:明确业务目标与数据运营愿景
一切数据运营的起点是业务目标。团队首先与高层、产品、运营共同对齐:未来一年核心目标是提升付费转化率和续费率。因此,数据运营体系的愿景是:让每个关键决策都有数据支撑,让每个运营动作都可衡量。
关键产出:业务目标树、数据运营愿景文档。
步骤2:梳理核心业务流程与用户旅程
绘制用户从触点到转化的完整旅程:广告点击→落地页→注册→试听→购买→学习→续费。识别每个阶段的关键行为与决策点。
关键产出:用户旅程地图、业务流程泳道图。
步骤3:设计指标体系(北极星指标+分层指标)
基于业务目标,确定北极星指标为“付费用户数”。并拆解为一级指标(如转化率、客单价)、二级指标(如试听转化率、购课转化率)、三级指标(如页面停留时长、按钮点击率)。
关键产出:指标字典、指标树。
步骤4:规划数据采集方案(埋点设计)
根据指标需求,设计埋点方案。采用“事件+属性”模型,定义关键事件(如课程试听开始、购买成功)及属性(如课程ID、来源渠道)。同时避避免过度埋点,确保每个埋点都有明确用途。
关键产出:埋点需求文档、埋点上报规范。
步骤5:数据采集与接入
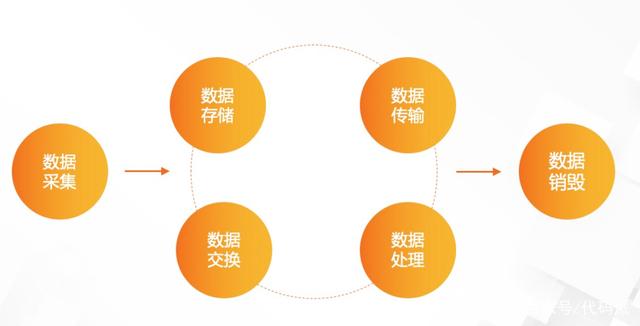
技术团队根据埋点方案,在客户端和服务端进行数据采集。采集方式包括:SDK自动采集、代码埋点、可视化埋点。数据接入数据仓库,通常采用Kafka+Flume+HDFS或直接入湖。
关键产出:数据接入管道、原始数据表。
步骤6:数据清洗与预处理
原始数据往往存在缺失、重复、格式错误、时间戳异常等问题。清洗步骤包括:去重、空值填充、格式转换、异常值处理、会话切割(session识别)。例如,将用户行为日志按时间排序,识别无效点击(如1秒内连续点击同一按钮)。
关键产出:清洗规则文档、清洗后数据表。
步骤7:数据建模与宽表构建
为提升查询效率,需对数据进行建模。常见模型包括:星型模型、雪花模型。基于用户旅程,构建用户行为宽表、订单宽表、课程维表等。宽表将常用维度与指标预聚合,减少重复计算。
关键产出:维度模型设计、宽表SQL脚本。
步骤8:数据存储与管理
选择合适存储方案:原始数据存HDFS/OSS,明细数据存Hive/ClickHouse,聚合数据存MySQL/Doris,实时数据存Kafka/Flink。同时建立数据分层:ODS(原始层)、DWD(明细层)、DWS(汇总层)、ADS(应用层)。
关键产出:数据分层规范、元数据管理。
步骤9:数据分析与可视化
基于指标体系,搭建BI看板。看板分为:高层驾驶舱(核心KPI)、业务监控看板(转化漏斗、留存曲线)、自助分析面板(维度下钻)。分析人员可借助SQL、Python进行深度分析,如归因分析、路径分析。
关键产出:BI看板、分析报告模板。
步骤10:数据运营行动与策略
数据只有转化为行动才有价值。例如,发现“试听->购买”转化率下降,通过漏斗分析定位到“支付页面加载慢”,推动技术优化;发现某渠道获客成本高但留存低,调整投放策略;针对高价值用户推送个性化课程推荐。
关键产出:运营策略清单、AB测试报告。
步骤11:效果评估与迭代优化
每个策略执行后,需评估效果。通过AB测试、前后对比、DID等方法,验证策略是否有效。定期复盘数据运营体系本身:指标是否合理?埋点是否遗漏?处理流程是否高效?形成迭代闭环。
关键产出:效果评估报告、体系优化backlog。
四、聚焦数据处理:从原始日志到可用数据
在上述11步中,数据处理是承上启下的关键环节。以下是一个典型的数据处理流程示例:
1. 数据采集:客户端埋点上报JSON日志至日志服务器,格式如:`json
{"event":"courseplay","userid":"123","course_id":"456","timestamp":1620000000,"platform":"ios","duration":120}`
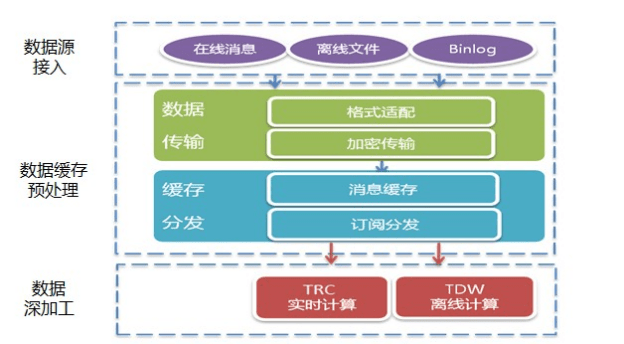
- 数据接入:通过Filebeat采集日志文件,Kafka缓冲,Flink消费并写入HDFS。
- 数据清洗:
- 过滤掉event为空的记录;
- 将timestamp转换为日期分区;
- 对duration为负数的记录标记为异常;
- 按user_id和timestamp排序,识别会话。
- 数据加工:
- 构建DWD层用户行为明细表,关联用户注册信息;
- 构建DWS层每日用户学习时长汇总表;
- 构建ADS层转化漏斗表,计算各环节转化率。
- 数据质量监控:设置规则,如数据量波动超过20%告警,空值率超过5%告警。
五、常见陷阱与应对建议
- 陷阱1:指标过多,失去焦点。应对:坚持北极星指标,分层管理,定期清理无效指标。
- 陷阱2:埋点混乱,数据不可信。应对:建立埋点评审机制,版本化管理埋点文档。
- 陷阱3:数据处理延迟高。应对:引入实时计算链路,对核心指标进行流式处理。
- 陷阱4:分析与行动脱节。应对:设立数据运营角色,定期组织数据复盘会。
六、
构建产品数据运营体系并非一蹴而就,而是一个持续迭代的过程。通过上述11个步骤,尤其是扎实的数据处理基础,团队可以逐步实现从“看数据”到“用数据”的跨越,最终让数据成为产品增长的引擎。记住:数据运营体系的终点不是报表,而是业务价值。